Шерлок против Бухгалтера: почему чистый векторный поиск проигрывает гибридному
Автоматический поисковый пайплайн проверяет десять тысяч спецификаций сырья, чтобы подтвердить соответствие кондитерской глазури стандарту V-Label: «Найти технические паспорта, содержащие краситель E120 или глазирователь E904».
Векторная база данных с гордостью возвращает первый результат с косинусным сходством 0.92:
«Органическая клубничная глазурь: яркий рубиновый ботанический экстракт, обеспечивающий натуральный красный оттенок для веганских десертов и выпечки».
Векторный поиск отлично уловил общую семантическую атмосферу «красного красителя для веганских сладостей». Но настоящий документ, который искал аудитор, утонул на 42-й строчке выдачи. Это был сухой двухстрочный сертификат: «Продукт содержит краситель E120 (кармин / экстракт кошенили из высушенных насекомых)».
Положившись исключительно на семантические эмбеддинги, система пропустила точный буквенно-цифровой код добавки, прямо нарушающий международный веганский регламент.
Так проявляется фундаментальное слепое пятно плотного векторного поиска.
Сыщик против конторщика
Чтобы понять, почему современные поисковые конвейеры объединяют два совершенно разных движка, полезно взглянуть на методы расследования.
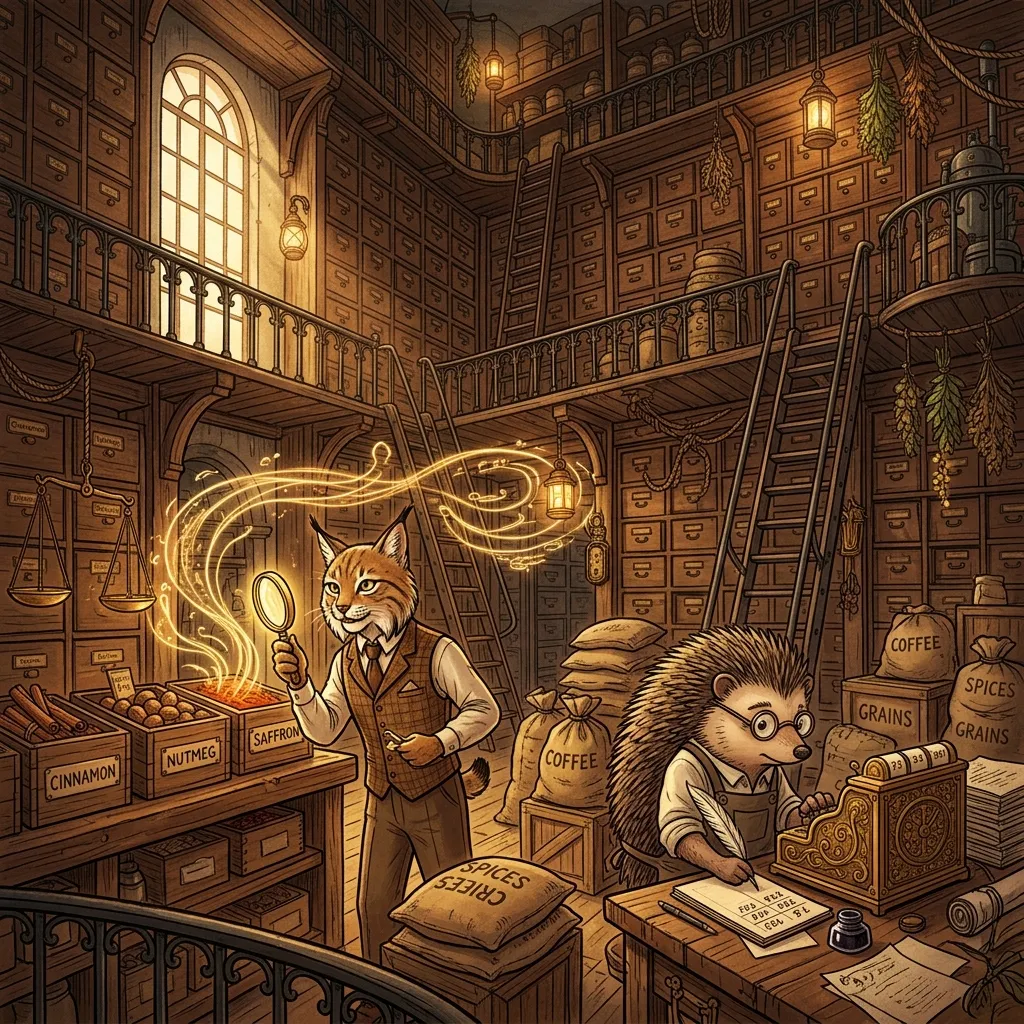
Представьте расследование кражи на историческом складе специй. На месте работают два сыщика с противоположным складом ума:
Детектив Шерлок опирается на интуицию, атмосферу и косвенные улики. Он чувствует запах трубочного табака, замечает царапины на ящике и сразу понимает, что вор нервничал, спешил и проник через речные ворота. Шерлок виртуозно связывает абстрактные смыслы, но ему невыносимо скучно перепроверять складские описи.
Конторщик-бухгалтер сидит в дальнем углу в круглых очках с нарукавниками и бухгалтерской книгой. У него нет никакой поэтической интуиции. Ему безразличны настроения, догадки и психологические портреты. Его волнует ровно одно: сходится ли штамп #E120-B на деревянном ящике со строкой в таможенной декларации.
Векторный поиск — это Шерлок: он блестяще понимает, что фраза «овсяный напиток без лактозы» по смыслу равна фразе «растительное молоко из злаков», но в упор не видит точные артикулы и коды.
Алгоритм BM25 — это Бухгалтер: он совершенно не понимает синонимов, метафор и контекста, но с пулеметной скоростью находит точную строчку E120 или CAS 56-81-5 среди миллиона страниц.
Здесь житейская аналогия дает сбой: в жизни детектив и бухгалтер могут обсудить дело за чашкой чая. В компьютерных науках они оценивают мир по абсолютно несовместимым шкалам. Векторный поиск выдает косинусное сходство от 0.0 до 1.0, а алгоритм BM25 — неограниченные статистические баллы от 0 до 45.8. Их нельзя просто сложить между собой.
Как считает Бухгалтер: Алгоритм BM25
Прежде чем объединять оба подхода, разберемся, почему BM25 (Best Matching 25) остается золотым стандартом лексического поиска на протяжении десятилетий:
BM25 Score(D, Q) = sum( IDF(q_i) · [ (TF · (k1 + 1)) / (TF + k1 · (1 - b + b · (|D| / avgdl))) ] )BM25 оценивает соответствие по трем строгим принципам:
- Частота термина (TF) с насыщением: Чем чаще искомое слово встречается в документе, тем выше балл. Но в отличие от наивного подсчета слов, в BM25 кривая плавно загибается: десять упоминаний кода
E120вовсе не в десять раз ценнее одного. - Обратная документная частота (IDF): Если слово «ингредиент» встречается в каждом документе базы, его вес обнуляется. Но если точный шифр
«E120»встречается всего в двух спецификациях на всю библиотеку, его статистический вес становится колоссальным. - Штраф за длину документа: Точное попадание редкого кода в коротком сертификате на три абзаца ценится гораздо выше, чем случайное мелькание того же слова в толстом каталоге на восемьсот страниц.
Математическая дилемма: Сложение теплого с мягким
Когда поисковый конвейер запускает оба движка одновременно, на выходе получаются два несовместимых списка:
- Векторный поиск (Dense): Выдает оценки в диапазоне от
0.00до1.00. - Поиск по ключевым словам BM25 (Sparse): Выдает баллы от
0.00до45.80с непредсказуемыми скачками в зависимости от редкости слов.
Попытка посчитать сумму напрямую:
Score = Vector_Cosine + BM25_Score # Ошибка: выбросы BM25 полностью подавят векторСтатистические выбросы BM25 мгновенно перекроют тонкие различия косинусных расстояний. Случайный черновик с четырьмя повторениями термина легко обгонит идеальный по смыслу документ.
Решение: Алгоритм Reciprocal Rank Fusion (RRF)
Современный гибридный поиск решает эту проблему через алгоритм Reciprocal Rank Fusion (RRF).
Вместо ненадежных абсолютных баллов алгоритм RRF полностью отбрасывает сырые оценки и учитывает исключительно порядковые места (ранги) документов в каждом из списков:
RRF_Score(d) = sum_over_retrievers( 1 / (k + rank_m(d)) )- Ранг
rank_m(d): Номер места документаdв поисковой выдаче движкаm(1-е место, 2-е место, 3-е место). - Константа
k: Равна60(эмпирический стандарт Белла и Кормака). Она сглаживает влияние первых мест, чтобы документ, занявший 1-е место только в одном поиске, не побеждал автоматически документ, занявший 2-е место в обоих сразу.
Как RRF распределяет победителей
Посмотрим на три типичных фрагмента спецификаций в выдаче:
- Фрагмент А (Подтвержден обоими): Занял 1-е место в BM25 (точное совпадение кода
E120) и 1-е место в векторном поиске (высокая релевантность теме глазури):Score = 1/(60 + 1) + 1/(60 + 1) = 1/61 + 1/61 ≈ 0.0328(Безоговорочный победитель!) - Фрагмент Б (Найден только вектором): Занял 2-е место в векторном поиске, но не найден BM25:
Score = 1/(60 + 2) + 0 = 1/62 ≈ 0.0161 - Фрагмент В (Найден только по коду): Занял 1-е место в BM25, но не распознан вектором:
Score = 1/(60 + 1) + 0 = 1/61 ≈ 0.0164
Фрагмент А выходит на самую верхнюю строчку, потому что его важность подтверждена и семантическим сыщиком, и дотошным конторщиком.
Реализация гибридного поиска в коде
В промышленных системах оба поисковых запроса выполняются параллельно, а списки результатов сливаются перед отправкой в языковую модель:
# Паттерн промышленного RAG: Параллельный поиск BM25 + Dense со слиянием RRF
def hybrid_compliance_search(query_text: str, top_k: int = 50, k_constant: int = 60):
    # 1. Получаем ранжированные списки кандидатов от обоих движков
    bm25_ranked_ids = bm25_index.search(query_text, limit=top_k)
    dense_ranked_ids = vector_index.search(query_text, limit=top_k)

    rrf_scores = {}

    # 2. Накапливаем ранговые веса лексического поиска BM25
    for rank, doc_id in enumerate(bm25_ranked_ids, start=1):
        rrf_scores[doc_id] = rrf_scores.get(doc_id, 0.0) + (1.0 / (k_constant + rank))

    # 3. Накапливаем ранговые веса векторного семантического поиска
    for rank, doc_id in enumerate(dense_ranked_ids, start=1):
        rrf_scores[doc_id] = rrf_scores.get(doc_id, 0.0) + (1.0 / (k_constant + rank))

    # 4. Сортируем документы строго по итоговому баллу слияния
    fused_candidates = sorted(rrf_scores.items(), key=lambda x: x[1], reverse=True)
    return [doc_id for doc_id, score in fused_candidates[:top_k]]
В строгом нормативном аудите ни интуиция, ни механический учет не работают поодиночке. Связка плотных векторов с классическим BM25 гарантирует, что система понимает общий замысел запроса, не теряя строгие буквенные шифры, от которых зависит легальность продукта.
В следующий понедельник, в Главе 6, мы разберем «Двухуровневый допрос (Cross-Encoder)»: почему прямая подача топ-50 кандидатов в языковую модель все еще приводит к галлюцинациям и как кросс-энкодер проводит пословный перекрестный допрос каждого фрагмента.
Случалось ли вам сталкиваться с ситуацией, когда векторный поиск упорно игнорировал точный артикул детали или код ошибки в пользу внешне похожего, но бесполезного описания?