Базовый цикл RL: Четыре шага в зоне клатча
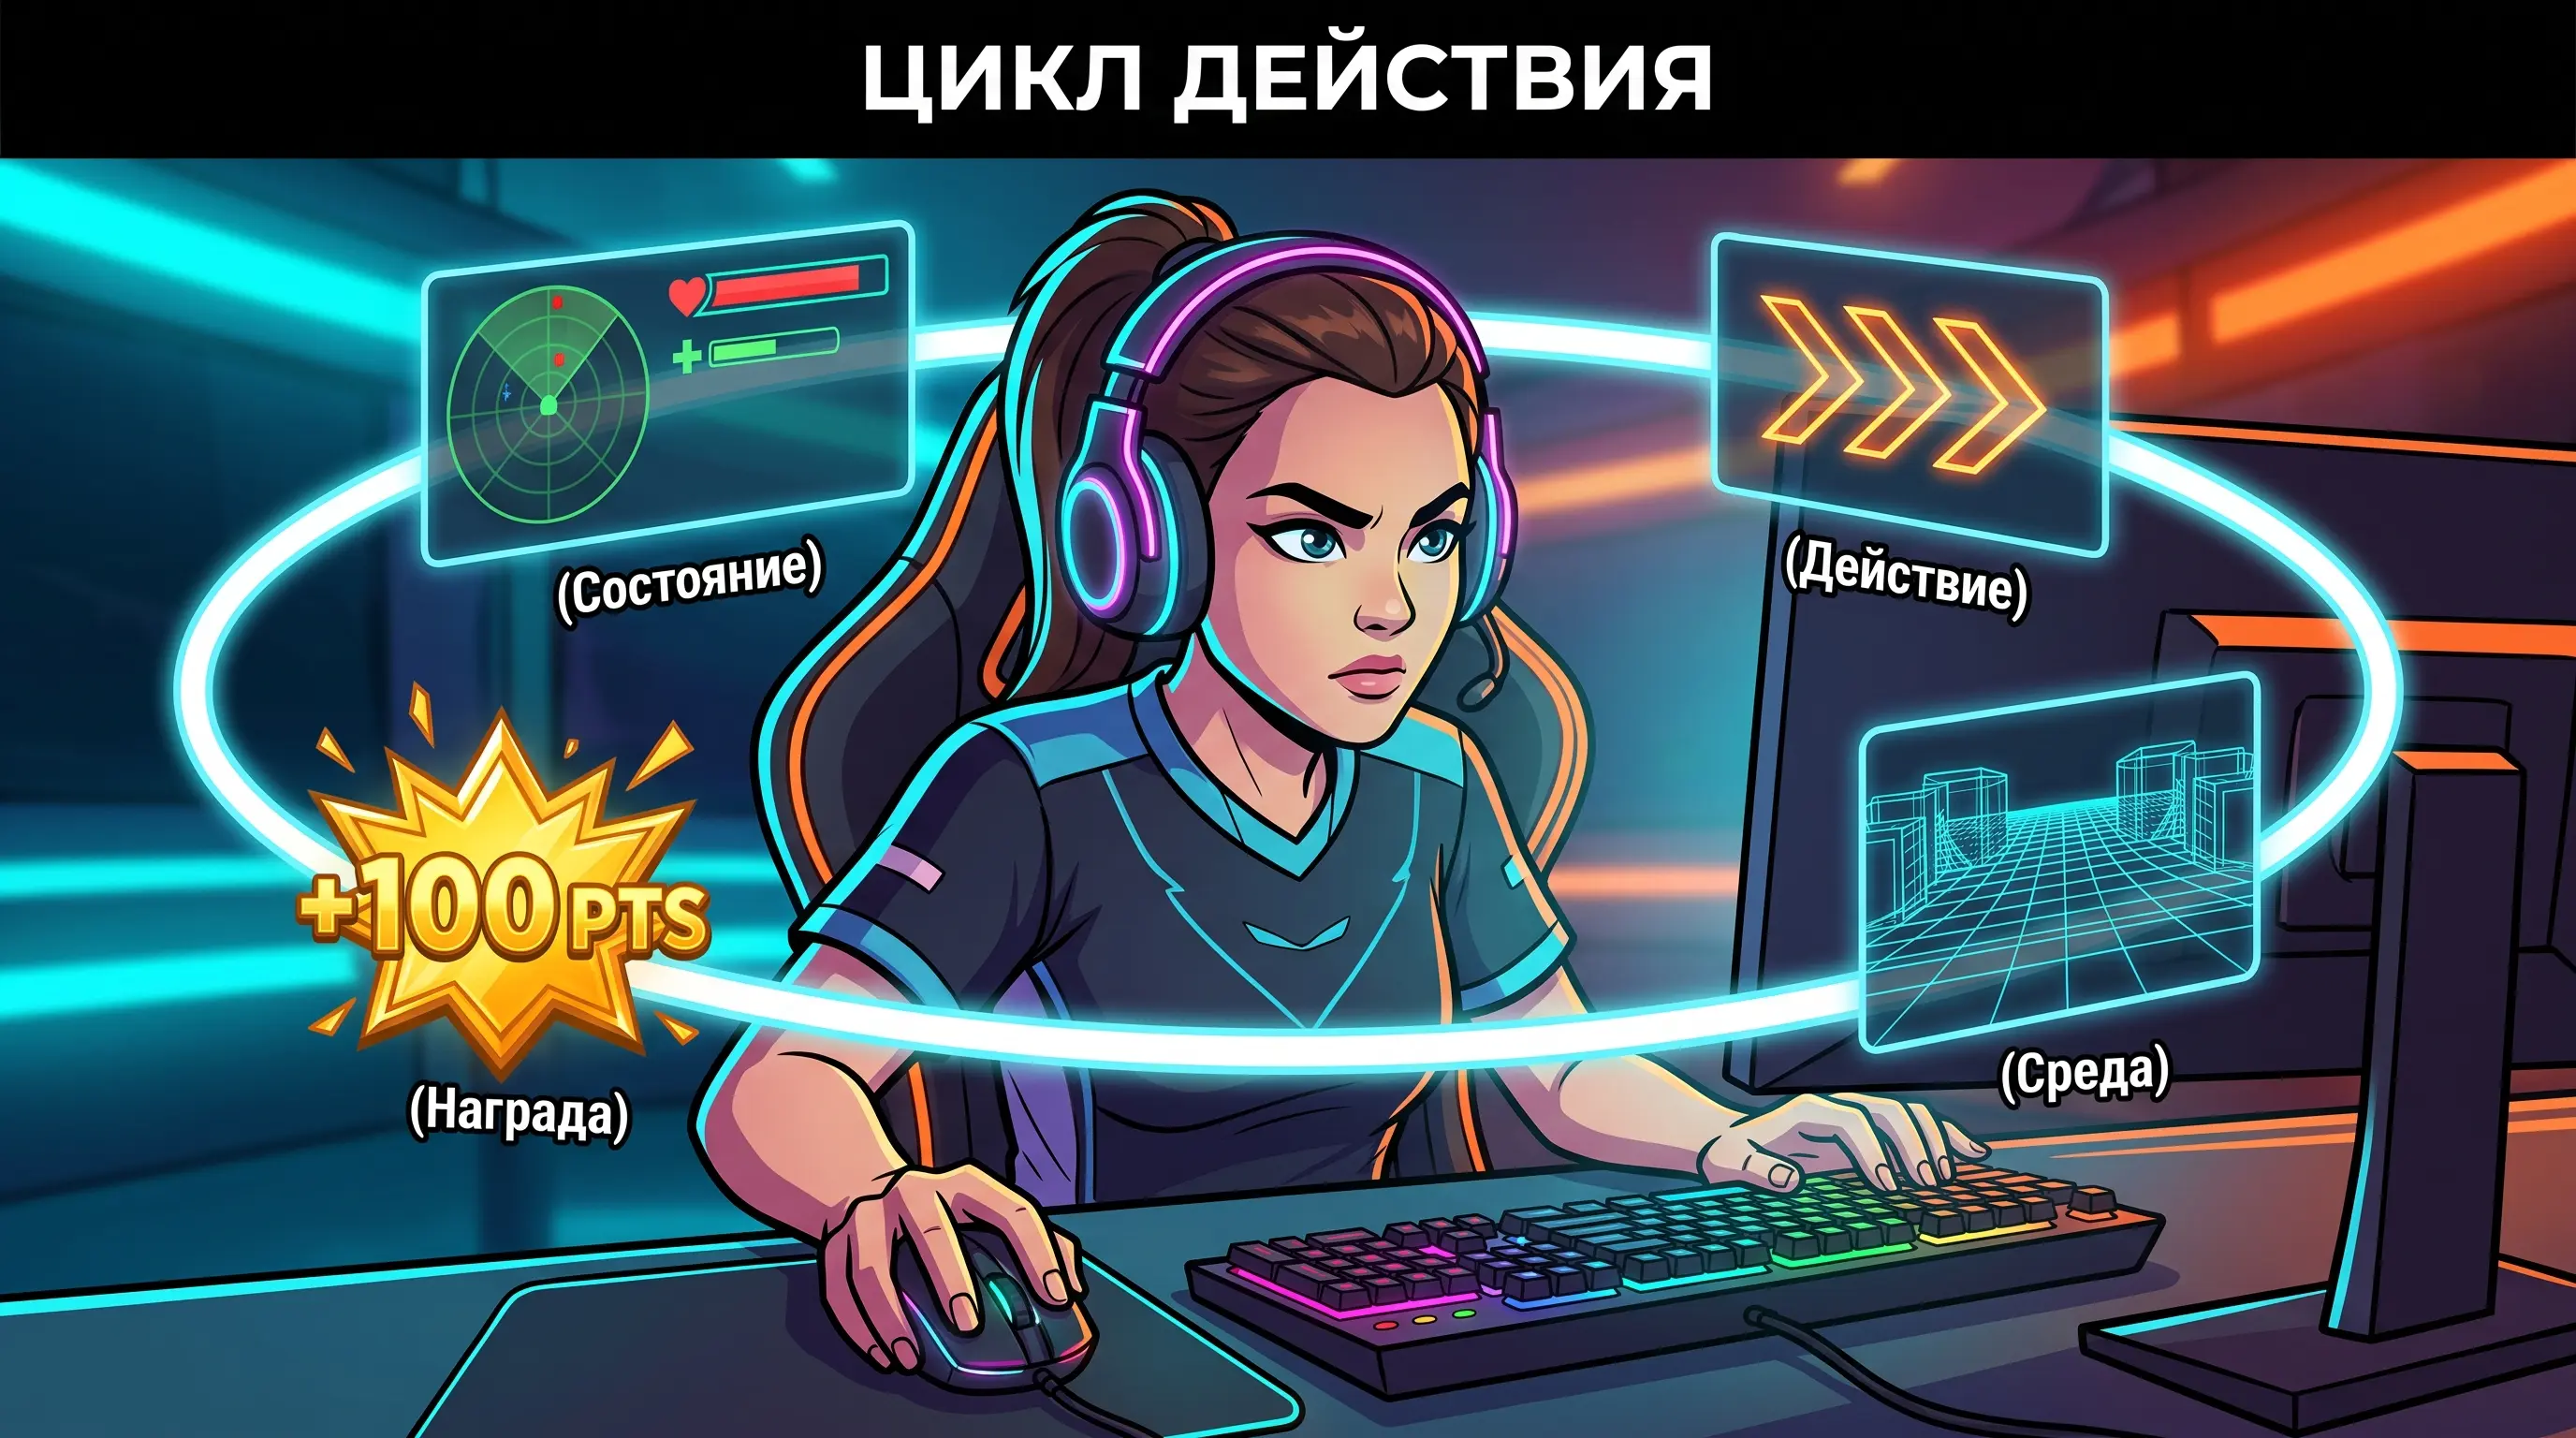
Посмотрите на киберспортсменку в последние пять секунд невозможного клатча один в один.
Она не смотрит на свои пальцы и не размышляет об абстрактной теории игр. Ее нервная система замкнута в непрерывный, яростный цикл, который прокручивается шестьдесят раз в секунду.
Сначала снимок реальности: взгляд сканирует экран. Четырнадцать ХП, два патрона в магазине, всплеск шагов соперника по воде слева. Это ее Состояние (State).
Рефлексы срабатывают мгновенно: резкий флик мышью, подкат за ящик и префайр в дверной проем. Это ее Действие (Action), продиктованное наработанным чутьем — ее Стратегией (Policy).
Игровой движок считывает клик, пересчитывает физику и траекторию пули. Это Среда (Environment).
Мгновение спустя прилетает обратная связь: характерный звонкий дзынь хедшота, противник падает, трибуны взрываются ревом. Это ее Награда (Reward).
Пикни она на полсекунды позже — экран залило бы красным, прозвучал бы звук поражения, и раунд был бы слит.
Реальность
Каждая система обучения с подкреплением — от нейросети, обыгравшей чемпионов мира в Dota 2, до роботизированной руки на складе — работает ровно по этому циклу. В науке это называется Циклом обучения с подкреплением (формально — Марковским процессом принятия решений, MDP).
В этой механике пять ключевых элементов:
- Агент (Agent): Сам ИИ-игрок за штурвалом.
- Среда (Environment): Мир, в котором живет агент (игровой сервер, симулятор автопилота или финансовый рынок).
- Состояние ($s_t$): Текущий срез реальности — все, что датчики агента видят прямо сейчас.
- Действие ($a_t$): Решение, которое агент принимает на основе увиденного.
- Награда ($r_t$): Числовая оценка от среды за содеянное (+100 за взятый раунд, -50 за полученный урон, 0 за безопасное перемещение).
Связывает все воедино Политика ($\pi$): внутренняя книга правил агента, определяющая, какое действие выбрать при каждом конкретном состоянии.
Почему это важно
Классический код говорит машине: «Если видишь X, делай Y». Обучение с учителем говорит: «Вот как поступил эксперт, когда увидел X».
Цикл обучения с подкреплением устроен принципиально иначе: он дает алгоритму субъектность. Агент совершает действие, мир вокруг него меняется, среда выдает мгновенный фидбек, и агент тут же корректирует свою тактику. Это не пассивный калькулятор, перемалывающий чужие архивы, а активный участник, познающий мир через цепочку причин и следствий.
Главная мысль
Интеллект — это не склад заученных знаний; это непрерывный цикл наблюдения, действия и проживания последствий.
Специалисты по ИИ называют это: Марковский процесс принятия решений (MDP) / Цикл взаимодействия агента и среды
На каждом дискретном временном шаге t агент считывает состояние s_t ∈ S, получает скалярную награду r_t ∈ R и выбирает действие a_t ~ π(a|s_t). Среда переходит в следующее состояние s_{t+1} ~ P(s'|s_t, a_t) и возвращает награду r_{t+1}. Цель агента — найти оптимальную стратегию π*, максимизирующую суммарный дисконтированный выигрыш G_t = Σ γ^k r_{t+k+1}.
💬 Вспомните самую сложную игру или вид спорта в вашей жизни. Сколько часов ушло на то, чтобы панический просчет каждого шага превратился в чистый автоматический рефлекс?
Часть 2 из 15 | #ReinforcementLearningForHumans
#ai_edu На основе лекций Стэнфорда и индустрии