Отложенное вознаграждение: Жадный фраг против победы в матче
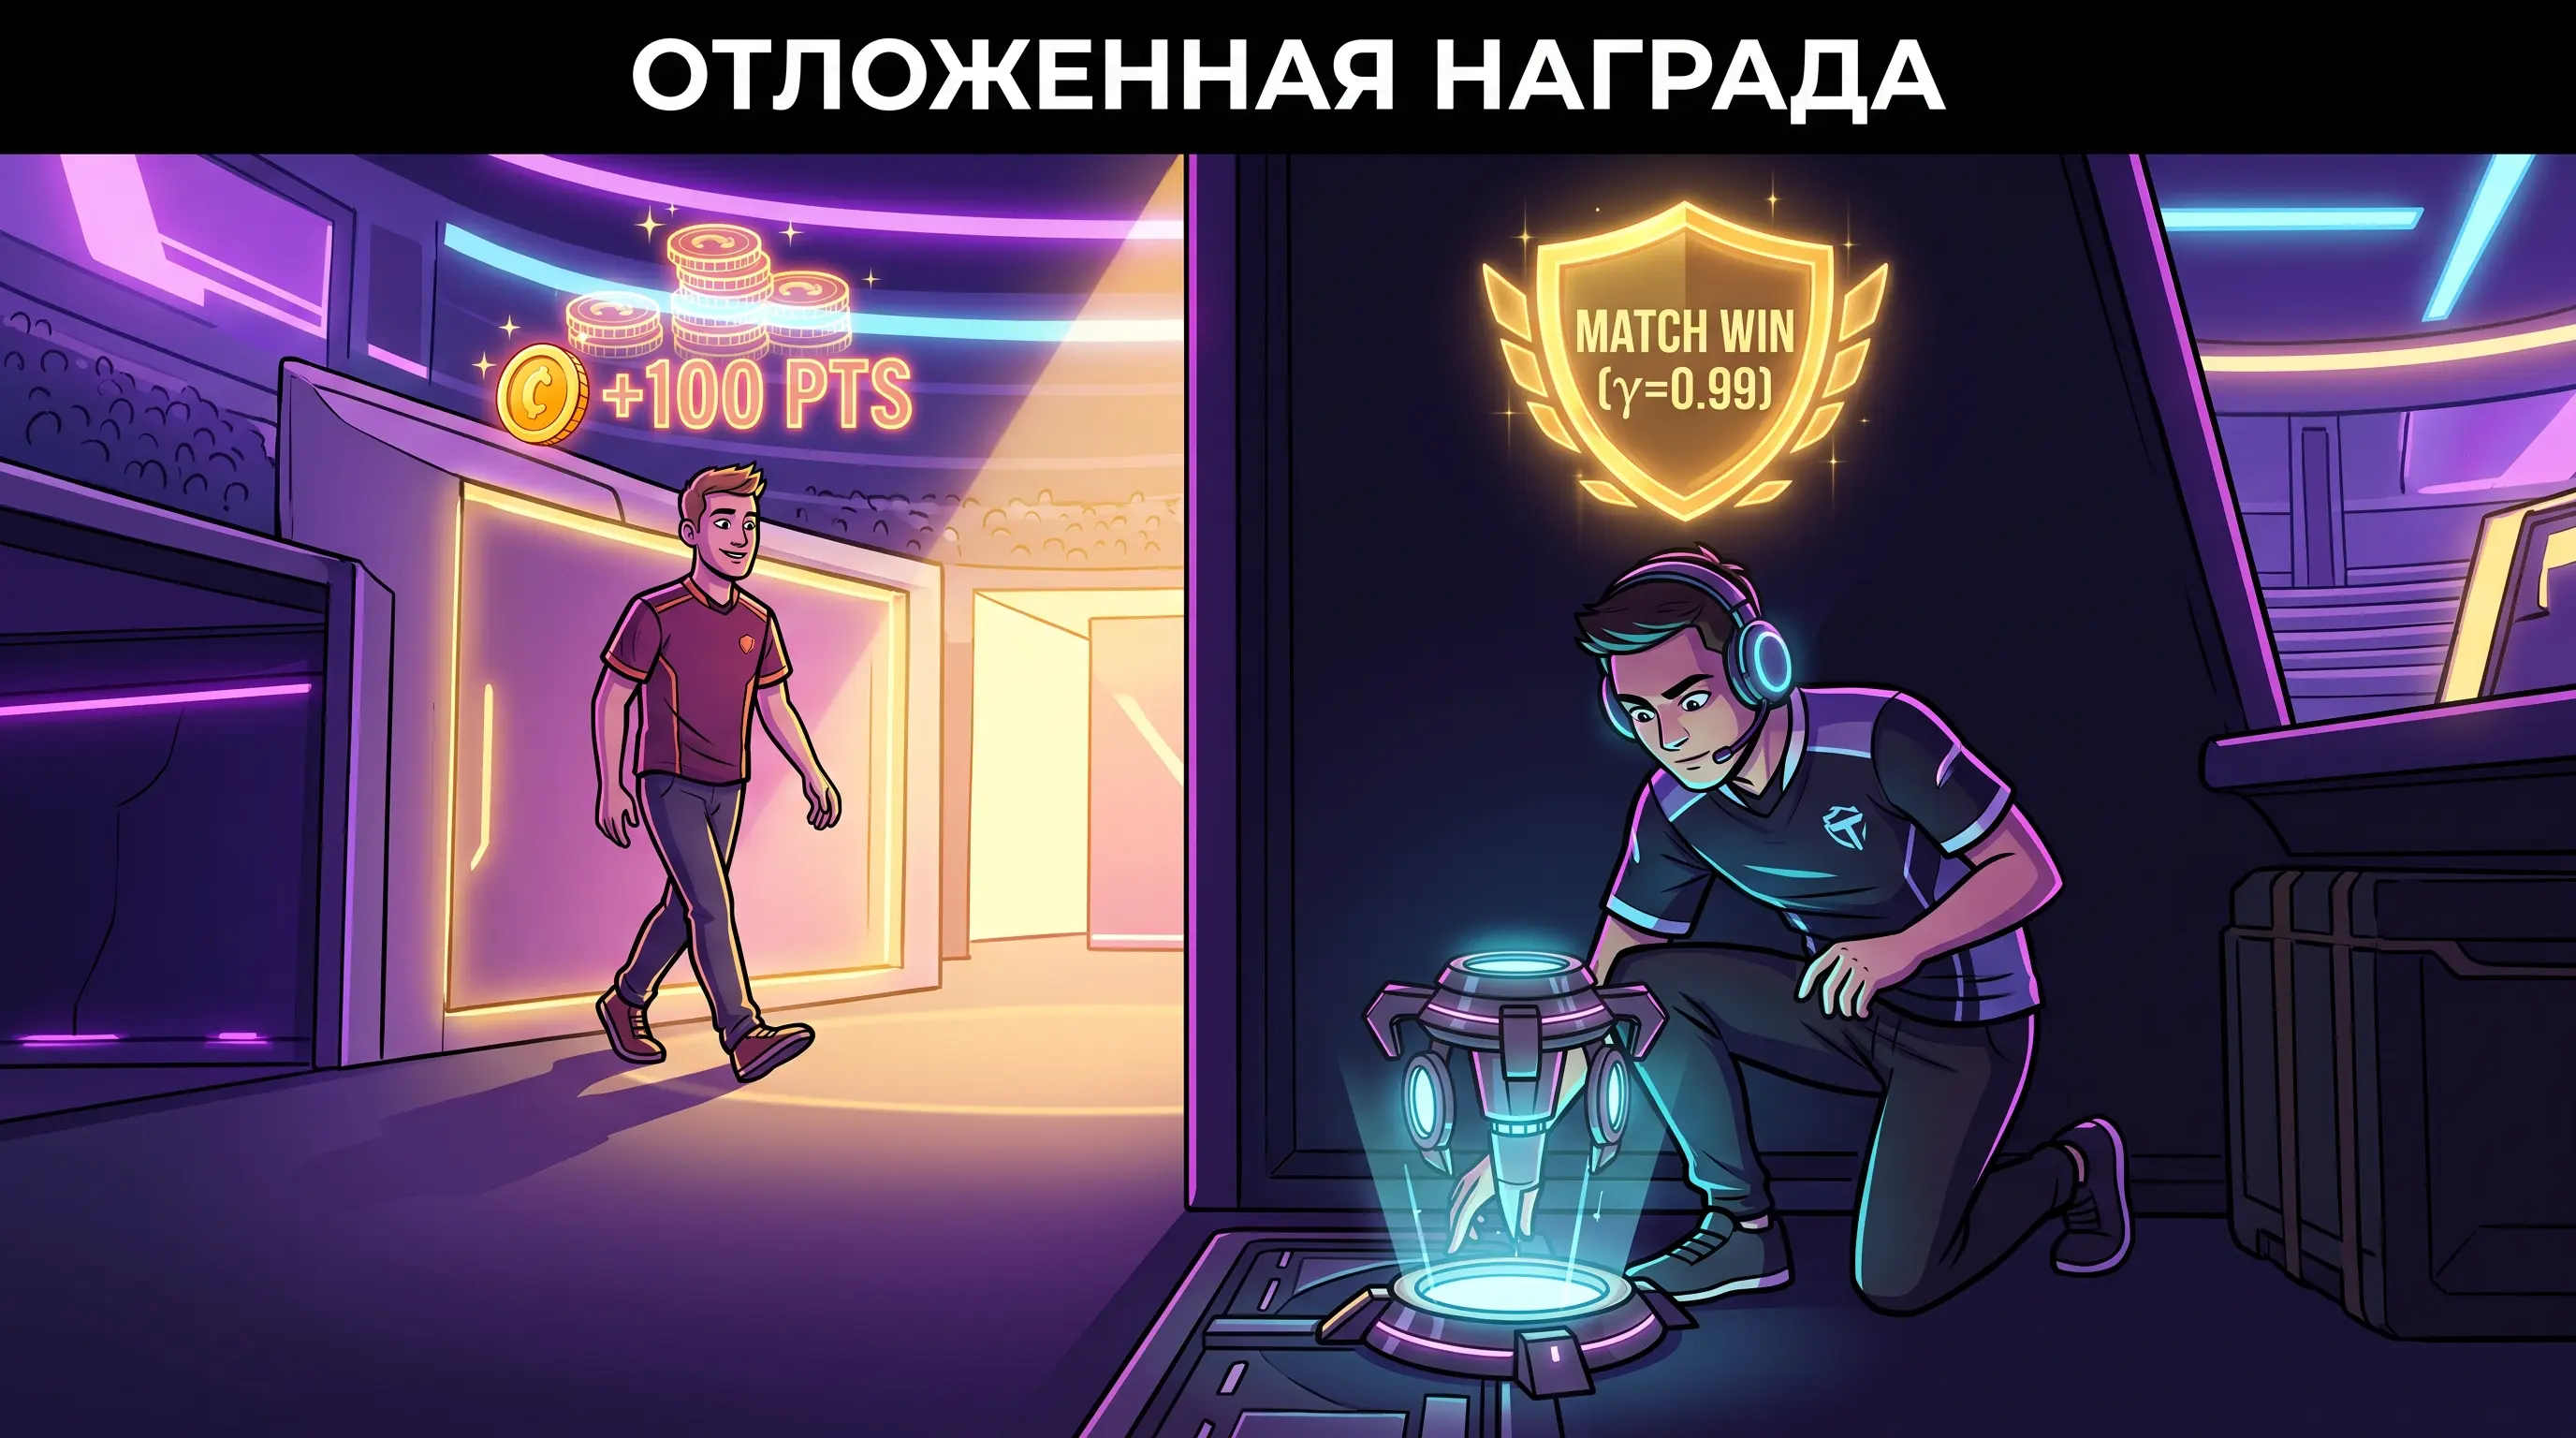
Любитель в тактическом шутере замечает противника, который зазевался и смотрит в другую сторону.
Мозг любителя требует мгновенного дофамина: легкий фраг, красивая статистика, быстрый кайф. Он срывается с места, зажимает гашетку и забирает легкое убийство. Игра тут же рисует на экране приятные +100 очков.
Ровно через десять секунд таймер раунда падает в ноль.
Команда проигрывает раунд, потому что никто не поставил бомбу. Хуже того: выдав свою позицию ради бесполезного фрага, игрок тут же ловит размен от двух оставшихся врагов, хороня экономику команды на три раунда вперед. Он выиграл сиюминутную микро-дуэль и слил всю катку.
А теперь посмотрите, как в этой же ситуации играет чемпион мира.
Она видит уязвимого противника. Прицел наведен прямо на его затылок. Но она не спускает курок.
Она пропускает его мимо себя в темноту коридора. На последних секундах бесшумно проскальзывает на точку, заводит спайк и берет раунд. Она осознанно отказалась от сотни очков прямо сейчас, потому что победа в раунде через десять секунд принесет команде в тридцать раз больше пользы.
Реальность
В обучении с подкреплением эту вечную борьбу между сиюминутной конфетой и стратегической победой регулирует один математический тумблер: Фактор дисконтирования (Discount Factor), обозначаемый греческой буквой Гамма ($\gamma$).
Гамма — это число от 0 до 1, определяющее, насколько сильно ИИ ценит будущее по сравнению с настоящим:
Если Гамма равна 0, модель абсолютно близорука. Ее волнует только та награда, которую можно урвать прямо в эту миллисекунду. Такой алгоритм с радостью подберет монетку на рельсах прямо перед несущимся поездом.
Если Гамма близка к 1 (например, 0.99), ИИ превращается в гроссмейстера. Награда, которая ждет его через пятьдесят ходов, все еще имеет огромный вес в сегодняшних расчетах. Модель учится терпению, тактическим жертвам и долгосрочному планированию.
Каждая будущая награда умножается на Гамму за каждый шаг до нее. Награда через один ход стоит $\gamma$ от своего номинала. Награда через два шага стоит уже $\gamma^2$. Чем выше Гамма, тем яснее агент видит горизонт; чем она ниже, тем быстрее будущее растворяется в тумане.
Почему это важно
В реальном мире правильные решения почти никогда не приносят мгновенных очков.
Пожертвовать фигуру в шахматах, притормозить перед опасным поворотом, отложить деньги на учебу или сесть ставить бомбу под свистом пуль — в моменте все это ощущается как нулевая польза или даже болезненный штраф. Без фактора дисконтирования любой искусственный интеллект обречен оставаться жадным гремлином: судорожно собирать копейки с пола, пока вокруг горит его собственный замок.
Главная мысль
Любители играют ради счета на табло в эту секунду; чемпионы играют ради счета на табло после финального свистка.
Специалисты по ИИ называют это: Фактор дисконтирования ($\gamma$) / Кумулятивный дисконтированный выигрыш (Cumulative Return)
Ожидаемый выигрыш G_t рассчитывается как дисконтированная сумма будущих наград: G_t = r_(t+1) + γ r_(t+2) + γ^2 r_(t+3) + ... = Σ γ^k r_(t+k+1). Параметр γ ∈ [0, 1) исключает бесконечные циклы в бесконечных задачах и математически балансирует сиюминутную жадность алгоритма со стратегическим долгосрочным планированием.
💬 Приходилось ли вам принимать решение, которое в моменте стоило вам комфорта или очков, но окупилось сторицей спустя месяцы или годы?
Часть 3 из 15 | #ReinforcementLearningForHumans
#ai_edu На основе лекций Стэнфорда и индустрии