Парашют в багажнике: почему кабинетные учения по аварийному восстановлению проваливаются на реальном сбое
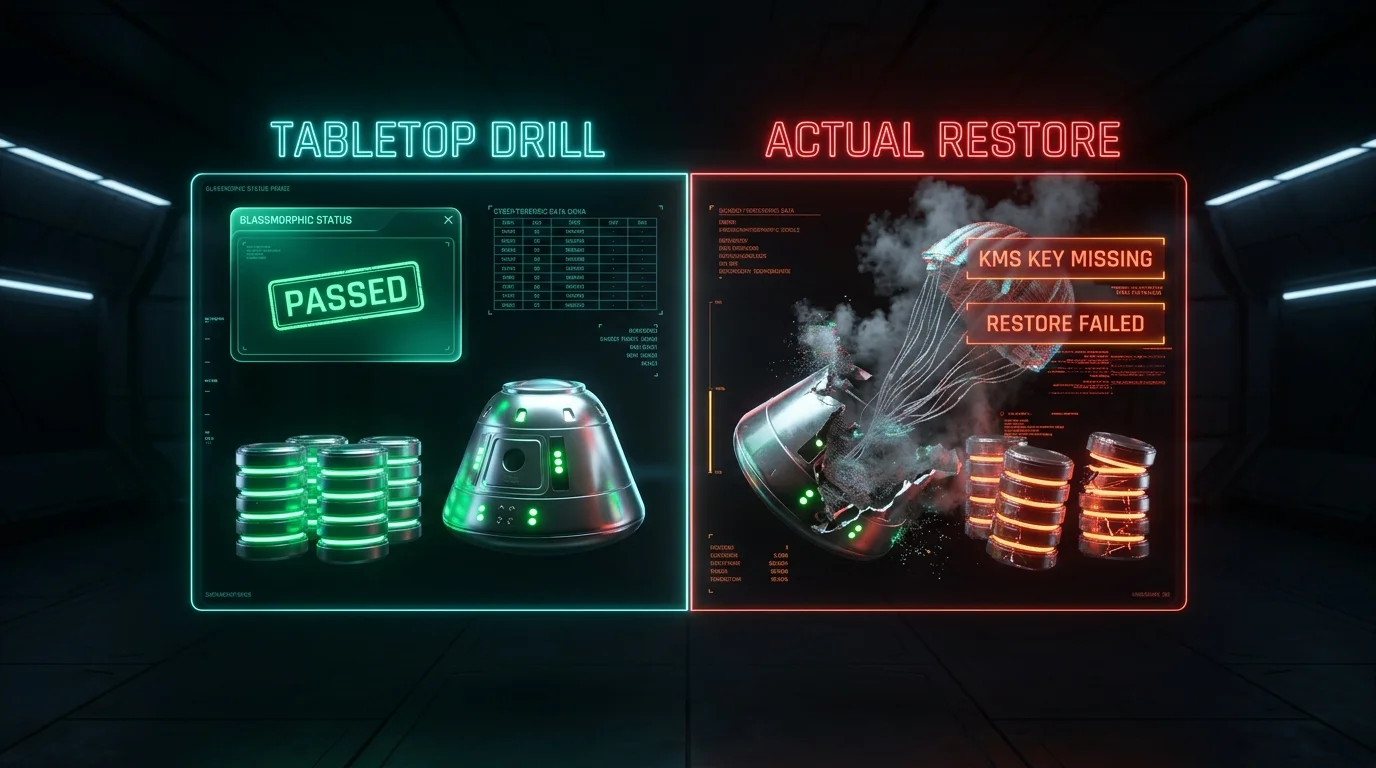
Раз в год, обычно за три недели до закрытия окна внешнего аудита по SOC 2 или ISO 27001, четыре руководителя разработки бронируют переговорку, заказывают обед и открывают Google Документ под названием «Ежегодные учения по плану аварийного восстановления (DRP)».
Шестьдесят минут команда устно проговаривает гипотетический сбой:
- «Если регион
eu-central-1полностью упадет, как мы поднимаем сервис?» - «Переключаем Terraform на резервный регион, подтягиваем ночной зашифрованный снимок RDS из реплики S3 и обновляем DNS-записи в Cloudflare».
- «Сколько это займет?»
- «Уложимся в четыре часа. Все автоматизировано».
Кто-то вписывает Статус: ПРОЙДЕНО внизу документа, делает скриншот зеленых галочек в консоли AWS Backup, экспортирует отчет в PDF и загружает его в систему комплаенса. Аудитор ставит зачет по контролю ISO 27001 (5.30 — готовность к непрерывности бизнеса) и критерию доступности SOC 2.
Ни один байт при этом не восстанавливался.
Такие учения напоминают привычку возить в багажнике сложенный парашют, раз в год проверять, не протерся ли нейлоновый чехол, и считать себя готовым к прыжку.
Что именно ломается в пустом облачном регионе
Когда случается масштабный сбой провайдера, атака шифровальщика или случайное удаление инфраструктуры, выясняется: резервная копия остается иллюзией, пока не развернута в изолированной сети с нуля. Реальное восстановление спотыкается о четыре сбоя, которых не видно на слайдах в переговорке.
1. Блокировка на ключах KMS
Инженеры включают шифрование для снимков баз данных и бакетов S3, как того требуют стандарты безопасности.
Но когда в резервном регионе запускается команда восстановления реплицированного снимка, консоль выдает KMSKeyNotFoundException. Система репликации исправно скопировала зашифрованные блоки данных, но сам клиентский ключ шифрования (CMK) остался привязан к политике основного региона, либо у сервисной роли в резервной зоне нет прав kms:ReEncrypt и kms:CreateGrant.
Данные бэкапа в сохранности. Математически без доступного ключа это обычный цифровой шум.
2. Циклические зависимости при разворачивании
Любая команда уверена, что ее инфраструктура полностью описана в коде через Terraform или OpenTofu.
Когда инженеры запускают terraform apply в чистом регионе, процесс останавливается на первой минуте. Где хранится файл состояния (tfstate)? В бакете S3 внутри упавшего региона. Откуда тянутся приватные Docker-образы? Из корпоративного реестра, который работает за неработающим корпоративным VPN. Где лежат секреты для CI/CD? В кластере Vault, чей внутренний DNS ведет в недоступную сеть.
Нельзя использовать работающий продакшн-кластер для подъема замены этому же кластеру.
3. Рассинхронизация состояния между хранилищами
План в документации исходит из того, что база данных содержит единую истину. Реальный сервис размазан по нескольким системам с разным ритмом резервного копирования:
- Реляционные таблицы PostgreSQL — снимок в 02:00 UTC.
- Пользовательские файлы в S3 — асинхронная репликация с лагом 15 минут.
- Векторные индексы поиска (Qdrant или Pinecone) — ночная пересборка.
- Брокер очередей Kafka — хранение логов за последние 72 часа.
Подъем базы за 02:00 UTC поверх файлов из S3 на состояние 02:14 UTC ломает целостность ссылок в тысячах записей. Воркеры приложения запускаются, находят в БД указатели на несуществующие вложения и падают в бесконечный цикл перезагрузок.
4. Фантастический таймер RTO
В отчетах для европейских регуляторов по регламенту DORA (Digital Operational Resilience Act) и в анкетах для крупных клиентов зафиксирован комфортный показатель времени восстановления: RTO < 4 часов.
Никто не засекает, сколько часов облачный провайдер физически разворачивает 8-терабайтный снимок из холодного хранилища, заново строит индексы B-tree и HNSW, прогревает пулы соединений и обновляет сертификаты TLS. В реальных авариях только гидратация дисковых томов занимает 14–24 часа до начала отладки самого приложения.
Инженерное решение: автоматические учения с развертыванием
Аудиторы принимают скриншоты обсуждений, потому что стандарт формально требует доказательств проверки плана. Ошибка — делать эту проверку в формате театрального совещания вместо автоматического еженедельного пайплайна.
Зрелый подход превращает аварийное восстановление в регулярную задачу CI/CD на базе изолированной песочницы.
[Еженедельный триггер по Cron (Воскресенье, 03:00 UTC)]
                  │
                  ▼
[Создание изолированной тестовой VPC в резервном регионе]
                  │
                  ▼
[Расшифровка и развертывание снимка БД] ──► Ошибка? ──► [Инцидент в PagerDuty: DR сломан]
                  │
                  ▼ Успех
[Синтетические проверки схемы и транзакций]
                  │
                  ▼
[Замер реального времени RTO + удаление песочницы]
                  │
                  ▼
[Отправка подписанного JSON-лога в хранилище аудита]
Вместо доверия зеленым индикаторам консоли AWS Backup, скрипт на базе GitHub Actions каждую неделю поднимает клон базы данных исключительно с теми ключами и переменными Terraform, которые будут доступны при потере основного региона:
import boto3
import time
import psycopg2

def execute_dr_verification(snapshot_arn, kms_key_id, target_subnet_group):
    rds = boto3.client("rds", region_name="eu-west-1")
    start_time = time.time()
    clone_id = f"dr-drill-{int(start_time)}"

    try:
        # 1. Тест кросс-регионального развертывания и доступа к ключам KMS
        rds.restore_db_instance_from_db_snapshot(
            DBInstanceIdentifier=clone_id,
            DBSnapshotIdentifier=snapshot_arn,
            DBInstanceClass="db.r6g.large",
            DBSubnetGroupName=target_subnet_group,
            KmsKeyId=kms_key_id
        )

        waiter = rds.get_waiter("db_instance_available")
        waiter.wait(DBInstanceIdentifier=clone_id)

        endpoint = rds.describe_db_instances(DBInstanceIdentifier=clone_id)[
            "DBInstances"
        ][0]["Endpoint"]["Address"]

        # 2. Проверка криптографической целостности и количества строк
        conn = psycopg2.connect(host=endpoint, dbname="prod", user="dr_probe")
        with conn.cursor() as cur:
            cur.execute("SELECT COUNT(*) FROM financial_ledger;")
            ledger_rows = cur.fetchone()[0]
            assert ledger_rows > 0, "Восстановленный реестр пуст!"

        actual_rto = round(time.time() - start_time, 2)
        return {"status": "VERIFIED", "actual_rto_seconds": actual_rto, "rows": ledger_rows}

    finally:
        # 3. Очистка временной тестовой инфраструктуры
        rds.delete_db_instance(DBInstanceIdentifier=clone_id, SkipFinalSnapshot=True)
Машинные логи надежнее протоколов совещаний
Когда внешний аудитор оценивает контроль SOC 2 Type 2 или инспектор DORA проверяет операционную устойчивость финтеха, файл с текстовым пересказом созвона показывает формализм.
Пятьдесят два последовательных воскресных JSON-лога с:
- точной меткой времени развертывания клона;
- подтверждением успешной расшифровки через KMS в изолированном контуре;
- контрольной суммой строк критичных таблиц;
- зафиксированным показателем
actual_rto_seconds: 1842.4
снимают любые вопросы. Если во вторник инженер случайно изменит политику ключа шифрования KMS и незаметно сломает резервное восстановление, воскресный автопрогон разбудит дежурного за месяцы до реального сбоя или прихода аудитора.
Бэкап — это не сжатый архив в объектном хранилище. Бэкап — это работающий сценарий восстановления с нуля.
Если ваш основной облачный регион полностью пропадет из сети прямо сейчас, какого числа в последний раз вы на практике проверяли, что у команды есть рабочие ключи расшифровки и автономные скрипты для запуска базы данных?