От Q-таблиц к Deep Q-Networks: Когда методичка плавится
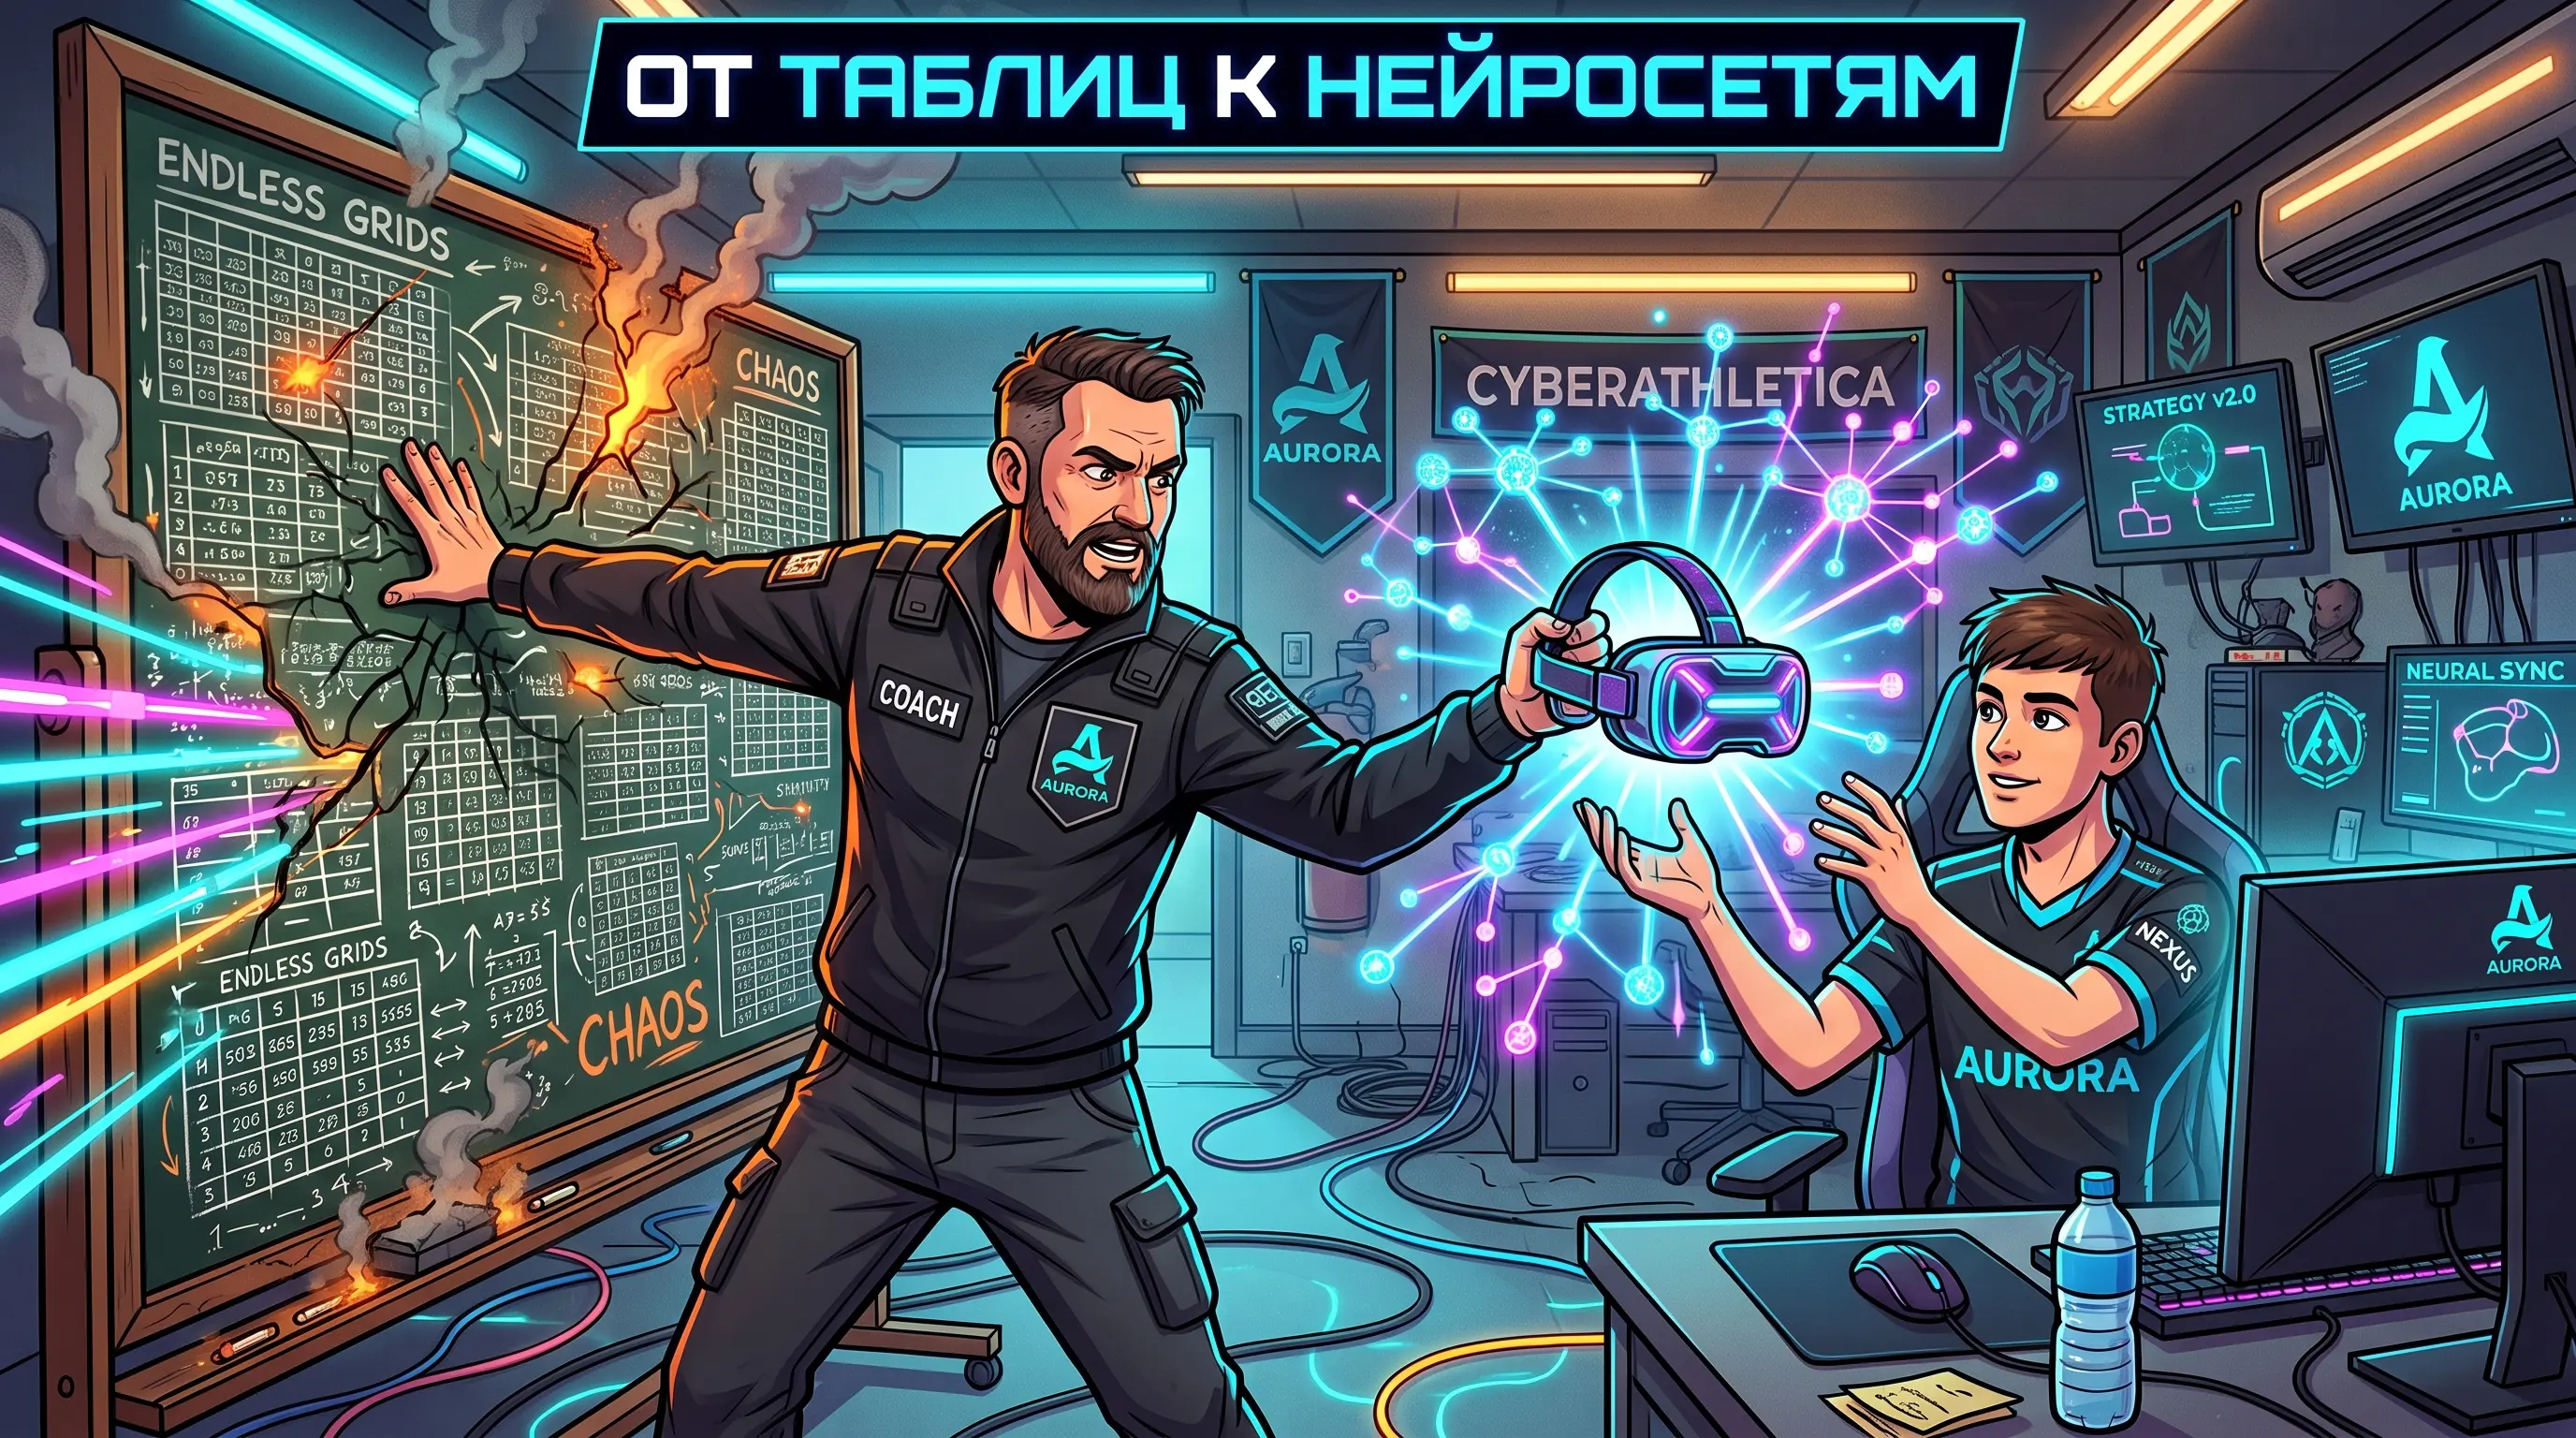
Представьте, что вы тренируете новичка для игры в крестики-нолики.
Вы можете набросать ему идеальную шпаргалку прямо на салфетке: если соперник пошел в угол, ты ставишь крестик в центр. Если пошел в центр — занимай противоположный угол. Все комбинации поля три на три легко умещаются в простую табличку в Excel, где для каждой ситуации прописана ценность любого хода.
В теории обучения с подкреплением такая шпаргалка называется Q-Таблицей (Q-Table).
А теперь представьте, что вы пытаетесь вручить ту же таблицу Excel киберспортсмену перед финалом чемпионата мира по Counter-Strike или StarCraft.
Каждый кадр на мониторе состоит из двух миллионов пикселей, а количество возможных визуальных сцен превосходит число атомов во всей обозримой Вселенной. Враг может выскочить слева на полном здоровье, справа на одном проценте ХП, с дробовиком, гранатой или пригнувшись за бочкой.
Если бы вы попытались создать Excel-файл с отдельной строчкой под каждый кадр игры, жесткий диск с такой таблицей схлопнулся бы в черную дыру от собственной массы.
Великий тренер не заставляет зубрить триллион страниц. Тренер ставит игроку интуицию.
Реальность
В классическом обучении с подкреплением агенты долгое время опирались на Q-Таблицы: матрицу, где в строках записаны Состояния, в столбцах — Действия, а в ячейках — Q-Значения (ожидаемая выгода за выбор этого хода).
Таблица прекрасно работает на игрушечных клеточных полях, но мгновенно умирает при столкновении с реальным миром. Это называется «Проклятием размерности».
В 2015 году лаборатория DeepMind совершила технологический прорыв, представив алгоритм Deep Q-Networks (DQN).
Вместо того чтобы пытаться запомнить бесконечную таблицу, ученые заменили Excel глубокой нейросетью. На вход сети подаются сырые пиксели с экрана игры, а нейросеть за считанные миллисекунды оценивает выгоду каждого возможного нажатия на геймпаде.
Почему это важно
Сила нейросетей заключается не в механическом заучивании, а в обобщении.
Нейросети не нужно, чтобы текущее расположение пикселей на экране встречалось ей раньше. Она учится вычленять высокоуровневые зрительные концепты: «это темное пятно — приближающаяся пуля», а «эта рамка — безопасное укрытие». Благодаря этому алгоритм безошибочно ориентируется в абсолютно новых игровых эпизодах, которых никогда не видел за миллионы часов тренировок.
DQN превратила безнадежный картотечный шкаф с бумажными снимками в гибкий цифровой двигатель игровой интуиции.
Главная мысль
Механическое заучивание работает, пока мир вокруг крошечный; когда реальность становится бесконечной, вам нужен двигатель интуиции.
Специалисты по ИИ называют это: Глубокие Q-сети (Deep Q-Networks, DQN) / Аппроксимация функции ценности
Вместо хранения табличных Q(s, a), DQN аппроксимирует функцию полезности глубокой нейросетью Q(s, a; θ). Сеть принимает на вход многомерный срез состояния (например, сырые пиксельные кадры) и возвращает расчетные Q-значения для всех действий, обучаясь минимизацией среднеквадратичной ошибки уравнения Беллмана.
💬 Пытались ли вы когда-нибудь выучить строгий свод правил для сложной работы, а потом осознали, что реальное мастерство пришло только вместе с насмотренностью и чутьем?
Часть 4 из 15 | #ReinforcementLearningForHumans
#ai_edu На основе лекций Стэнфорда и индустрии